Se você está cansado de assinaturas mensais drenando sua carteira ou limites de tokens interrompendo seu ritmo justamente quando você está no auge, saiba que não está sozinho. Configurar seu próprio ambiente de IA local é a solução definitiva para retomar o controle, proteger seu código e parar de depender dos caprichos dos servidores em nuvem.
Para quem se aventura nesse campo, especialmente com máquinas poderosas como o novo Mac mini M4, o ecossistema pode parecer um labirinto. No entanto, a chave é entender que você não precisa de uma única ferramenta mágica, mas sim de um conjunto de ferramentas composto por um mecanismo de inferência, um modelo de código especializado e uma interface que atue como um agente autônomo.
Os pilares de um assistente de código local
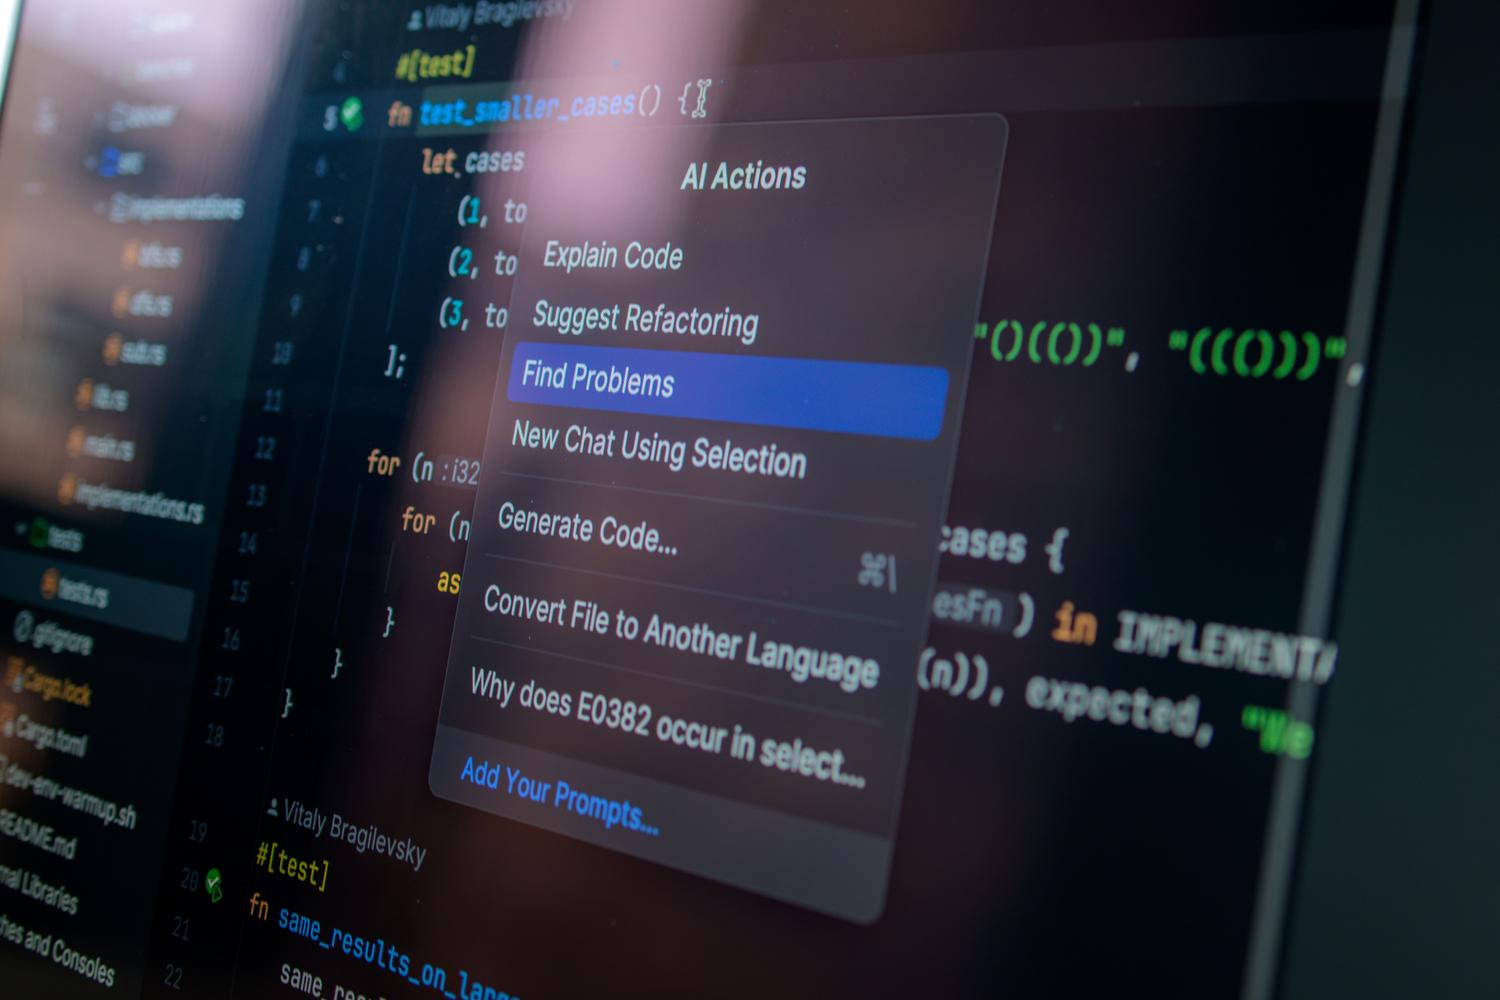
Para que tudo funcione sem ter que copiar e colar trechos de código sem parar, você precisa de quatro camadas bem definidas. A primeira é o ambiente de execução , onde o Ollama e o LM Studio reinam absolutos devido à sua facilidade de uso para disponibilizar modelos por meio de APIs compatíveis com OpenAI. Em seguida, vem o modelo de linguagem (LLM) , que é o cérebro que raciocina; aqui, a família Qwen2.5-Coder se tornou o padrão ouro por seu equilíbrio entre tamanho e capacidade.
O terceiro elemento é o cliente ou interface IDE , como a extensão Continue para o VS Code, que oferece autocompletar e chat integrado. Por fim, existem os agentes de ação , que são ferramentas mais avançadas como o Cline ou o Aider, capazes de ler arquivos inteiros, executar comandos no terminal e sugerir alterações reais no repositório sob sua supervisão.
Modelos recomendados com base no seu hardware
Nem todos os modelos são compatíveis com todas as máquinas. A regra de ouro é que a memória unificada, ou VRAM , é o verdadeiro gargalo, muito mais do que a potência bruta do processador. Se você tem um computador básico com 16 GB de RAM, os modelos de 7 GB ou 8 GB são a melhor opção para tarefas rápidas e bate-papo leve.
- Qwen2.5-Codificador 1.5B: Ideal para preenchimento automático instantâneo (preenchimento automático com a tecla Tab) sem deixar seu computador lento.
- Qwen2.5-Codificador 7B/14B: O ponto ideal para quem busca equilíbrio entre velocidade e raciocínio lógico.
- Qwen2.5-Codificador 32B: Para quem tem 24 GB de VRAM ou mais e precisa de um programação séria e profissional que se aproxima da qualidade dos modelos comerciais.
- DeepSeek-Coder-V2 Lite: Uma alternativa brutal para tarefas de lógica complexa ou algoritmos pesados.
Ferramentas e agentes: qual escolher?
Dependendo do nível de autonomia que você deseja conceder à IA, você tem diversas opções. Se preferir algo integrado ao editor, o Continue é o ponto de partida ideal. Se você busca um agente capaz de editar vários arquivos automaticamente e gerenciar commits do Git, o Aider é a ferramenta definitiva para o terminal, pois otimiza o uso de tokens por meio de mapeamentos de repositório.
Por outro lado, temos o Goose , um agente de código aberto altamente versátil que pode interagir com o sistema de arquivos e ser estendido por meio de servidores MCP. Para quem busca algo mais visual, o AnythingLLM permite o gerenciamento de conhecimento local e a indexação de documentos, embora seja mais uma ferramenta de produtividade do que um programa de desenvolvimento propriamente dito. Há também projetos emergentes como o OllamaCode , que se concentram em permitir que a IA não apenas escreva código, mas também o execute e teste em tempo real.
Configuração passo a passo para um fluxo de trabalho eficiente
Para que tudo funcione perfeitamente, o ideal é começar instalando o Ollama e baixando o modelo que melhor se adapta à sua memória (por exemplo, ollama pull qwen2.5-coder:14bAssim que o modelo responder corretamente no console, nós o conectamos ao VS Code usando a extensão ContinuarConfigurar o URL do localhost para que o chat e as edições ocorram em sua própria máquina.
Se você quiser levar as coisas para o próximo nível, pode instalar o Cline para ter um agente que sugere alterações no shell e nos arquivos, sempre pedindo sua permissão antes de executar qualquer coisa. Para um fluxo de trabalho mais robusto, usar o Aider permitirá que você realize refatorações em vários arquivos com incrível precisão, aproveitando o conhecimento que o agente tem da sua estrutura Git.
Privacidade, custos e desempenho
A principal vantagem dessa abordagem é a privacidade absoluta ; seus segredos comerciais e chaves de API nunca são enviados para nenhum servidor externo, o que é vital se você trabalha em setores regulamentados. Além disso, depois de investir no hardware, o custo por token é literalmente zero, eliminando a frustração dos limites de uso nas versões Cloud Pro.
Em termos de desempenho, a latência cai drasticamente, já que não há viagens de ida e volta pela rede. No entanto, tenha cuidado com o cache KV ; se você notar que a IA está repentinamente mais lenta, provavelmente a VRAM se esgotou e o sistema está usando a RAM comum, que é muito mais lenta. A solução é reduzir o tamanho do contexto ou usar um modelo menor.
Dicas para não interromper o projeto
Entregar as chaves do seu terminal a uma IA pode ser perigoso sem supervisão. A abordagem mais inteligente é aplicar um princípio de permissões restritivas : permita que a IA leia os arquivos primeiro, depois proponha o plano e somente então grave as alterações. Nunca permita que um agente execute comandos para excluir arquivos ou realizar instalações em massa sem antes verificar o comando exato.
É recomendável trabalhar em branches Git dedicadas para testes de IA. Dessa forma, se o agente decidir refatorar e quebrar todo o projeto, você pode reverter com um único comando. A abordagem vencedora é: objetivo pequeno, inspeção de contexto, aprovação de um patch limitado e validação com testes reais antes de fazer o commit final.
A combinação de um ambiente de execução como o Ollama, modelos poderosos da série Qwen e agentes autônomos como o Aider ou o Cline transforma um computador pessoal em uma estação de trabalho de desenvolvimento completa. Ao priorizar a memória unificada e gerenciar as permissões de execução, qualquer programador pode eliminar a dependência de cotas na nuvem e desfrutar de um fluxo de trabalho fluido, privado e totalmente gratuito.