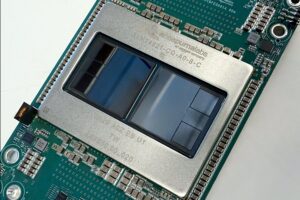
A OpenAI deu um passo significativo em sua estratégia de independência tecnológica com a apresentação dos primeiros resultados de seu processador de IA personalizado, apelidado de Jalapeño. Desenvolvido em colaboração com a Broadcom, este chip focado em inferência superou os aceleradores Nvidia GB200 e GB300 em duas métricas principais: potência de processamento por watt e velocidade de resposta. Os dados, divulgados na conferência Hot Chips e noticiados por veículos como Bloomberg e The Verge, posicionam a OpenAI de forma inédita na corrida por hardware de IA.
Este anúncio não é trivial. Até agora, a OpenAI dependia quase que exclusivamente de processadores Nvidia para executar seus modelos, tanto nas fases de treinamento quanto de inferência — ou seja, quando o sistema responde às consultas dos usuários. Com o Jalapeño, a empresa pretende reduzir seus custos operacionais e obter controle sobre sua infraestrutura, sem, no entanto, abandonar completamente a Nvidia. Segundo Richard Ho, chefe de hardware da OpenAI, o chip oferece o que ele chama de "o melhor dos dois mundos": alta capacidade para atender muitos clientes simultaneamente e baixa latência para aplicações interativas.

O que é Jalapeño e como funciona?
O Jalapeño é um circuito integrado de aplicação específica (ASIC), projetado desde o início para uma única tarefa: executar modelos de linguagem pré-treinados. Ao contrário das GPUs da Nvidia, que são processadores de uso geral, este chip é otimizado para a fase de inferência, onde o sistema processa uma solicitação e gera uma resposta. Ele não se destina ao treinamento de modelos, uma tarefa que permanece domínio das GPUs da Nvidia e que a OpenAI continuará a usar para esse fim.
O design do chip concentra-se na redução de gargalos que normalmente ocorrem durante a inferência, como a movimentação de dados entre a memória e as unidades de computação. De acordo com a empresa, o Jalapeño integra uma grande seção de computação juntamente com seis blocos de memória de alta largura de banda (HBM), permitindo que os dados sejam mantidos localmente e evitando transferências desnecessárias. Além disso, o chip pode ativar a combinação apropriada de recursos para cada fase de processamento, melhorando tanto o desempenho da IA quanto a eficiência energética.
Resultados de benchmark em comparação com a Nvidia
Os testes foram conduzidos utilizando a plataforma pública InferenceX da SemiAnalysis, que mede o desempenho de sistemas de IA em condições reais. A OpenAI comparou o Jalapeño com os melhores resultados obtidos pelos superchips Nvidia GB200 e GB300, que eram os benchmarks disponíveis na época dos testes. Os resultados mostraram que o Jalapeño alcança entre 1,5 e 1,9 vezes mais trabalho de IA por watt e latência de ponta a ponta entre 1,7 e 3,6 vezes menor. Os modelos utilizados no conjunto de testes foram GPT-OSS 120B, DeepSeek R1 e Kimi K3 , uma combinação que varia de modelos de pesos abertos a modelos de vanguarda.
Esses números são especialmente relevantes porque a eficiência energética se tornou um dos principais desafios do setor. Os data centers de IA consomem quantidades enormes de eletricidade, e a redução do consumo por unidade de trabalho pode gerar economias significativas. De acordo com Richard Ho, o Jalapeño opera com cerca de 700 watts, um valor relativamente baixo para um acelerador de inferência, e poderia reduzir os custos operacionais em cerca de 50% em comparação com GPUs convencionais, segundo Hock Tan, CEO da Broadcom.
Colaboração com a Broadcom e roteiro de desenvolvimento.
O desenvolvimento do Jalapeño é resultado de uma aliança estratégica entre a OpenAI e a Broadcom, anunciada em outubro de 2025. A Broadcom contribui com sua expertise em design de silício, redes e fabricação, enquanto a OpenAI utiliza seus próprios modelos de IA para acelerar o processo de design. O chip passou do projeto inicial à finalização do processo de fabricação (tape-out) em apenas nove meses — um tempo recorde para um semicondutor avançado.
A OpenAI já está trabalhando na segunda geração do processador e tem uma terceira em desenvolvimento. A empresa planeja implantar os primeiros sistemas com o Jalapeño em volumes muito pequenos até o final de 2026 e expandir significativamente seu uso durante 2027. De acordo com a Bloomberg, a implantação ocorrerá em data centers da Microsoft e de outros parceiros, e a escala deverá atingir 10 gigawatts de poder computacional até 2029. No entanto, os resultados apresentados são preliminares e ainda não foram validados em um ambiente de produção em larga escala.
Implicações para o mercado e os usuários
A chegada do Jalapeño não significa que a OpenAI esteja abandonando a Nvidia. A empresa insiste que a Nvidia continua sendo uma parceira fundamental, especialmente para o treinamento de modelos, e que a demanda por poder computacional é tão alta que exige múltiplos fornecedores. De fato, a OpenAI também trabalha com a AMD e a Cerebras, e sua estratégia envolve a construção de uma infraestrutura heterogênea, onde cada carga de trabalho é atribuída ao hardware mais eficiente.
Para usuários e desenvolvedores, essa notícia tem implicações diretas. Se a Jalapeño cumprir suas promessas, o custo por token de inferência poderá cair entre 30% e 50% nos próximos 18 meses, permitindo que startups e empresas ofereçam serviços de IA mais acessíveis e com menor latência. Além disso, a competição no mercado de chips de IA está se intensificando, o que pode se traduzir em melhores preços e mais opções para os usuários finais.
Por fim, vale ressaltar que os testes não incluíram uma comparação com a nova arquitetura Vera Rubin da Nvidia, que começou a ser comercializada recentemente. Portanto, a vantagem do Jalapeño pode diminuir quando a Nvidia lançar sua próxima geração. Mesmo assim, o progresso da OpenAI demonstra que a indústria de IA está entrando em uma nova fase, onde o hardware personalizado desempenhará um papel cada vez mais importante. A corrida por eficiência e velocidade está apenas começando.